Données aberrantes en agriculture : les détecter sans coder avec Orange Data Mining
Quand les données nous jouent des tours
Sur le terrain, les données ne sont jamais parfaites. Une sonde d’humidité mal positionnée, un couvert nuageux lors d’une acquisition satellite, un prélèvement de sol réalisé juste après un apport d’engrais… autant de situations qui génèrent des valeurs sortant du lot. Ces données aberrantes, ou outliers, peuvent passer inaperçues dans un tableau Excel et fausser silencieusement une analyse, une moyenne ou une recommandation.
Pour un technicien expérimentateur par exemple, l’enjeu pourrait être double : identifier ces points suspects sans passer des heures à éplucher des colonnes de chiffres, et comprendre s’il s’agit d’une vraie anomalie agronomique ou d’un simple artefact de mesure.
Détecter ces aberrants, sans une ligne de code
La bonne nouvelle, c’est qu’il existe aujourd’hui des outils « no-code » open source capables d’automatiser cette détection, sans nécessiter de compétences en programmation. Ces outils fonctionnent en connectant visuellement des blocs de traitement, comme on assemblerait des pièces de puzzle. Parmi eux, Orange Data Mining (ODM) se distingue par sa simplicité d’usage et la richesse de ses algorithmes de détection d’anomalies.
ODM est un logiciel gratuit et open source, développé par l’Université de Ljubljana. Son interface fonctionne par glisser-déposer : on charge ses données, on connecte des widgets entre eux (nettoyage, visualisation, modélisation), et on obtient des résultats en quelques clics. Pour la détection d’outliers, il propose notamment la distance de Mahalanobis, qui tient compte des corrélations entre variables, et le Local Outlier Factor (LOF), particulièrement efficace pour détecter des groupes de points suspects.
Petit exemple pour illustrer nos propos
Pour illustrer la démarche, prenons un jeu de données simulé représentant 67 observations issues d’une parcelle de blé. Chaque point combine deux mesures issues de télédétection :
• NDVI (Normalized Difference Vegetation Index) : indice de verdeur de la végétation, compris entre 0 et 1 ;
• LST (Land Surface Temperature) : température de surface en degrés Celsius.
Ces deux variables entretiennent une relation physique : une végétation dense transpire et refroidit la surface (NDVI élevé = LST basse).
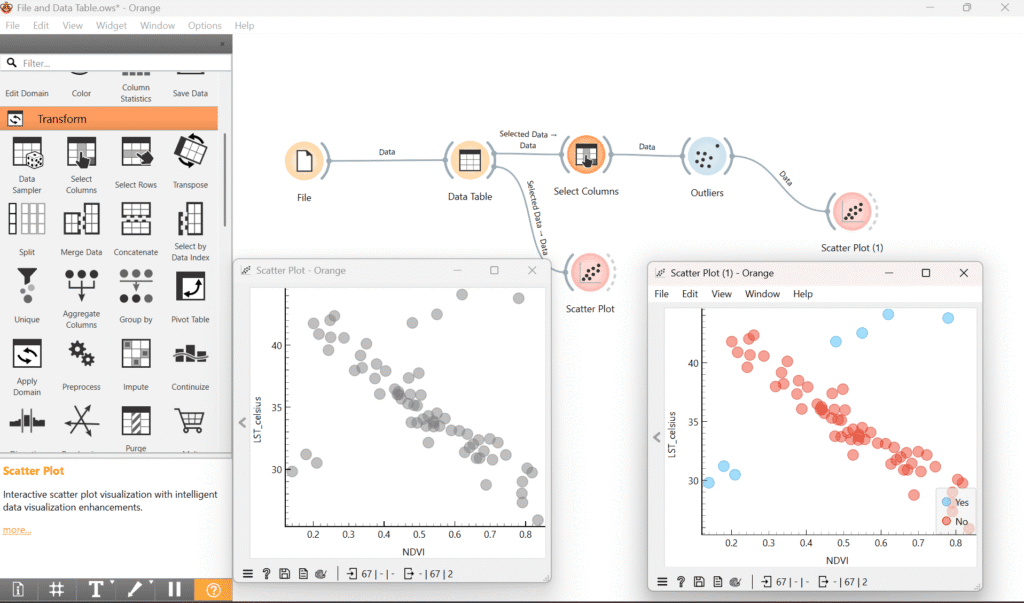
Ci-dessous le résultat obtenu. Dans le scatterplot (1) en bas à droite, on peut apercevoir que les outliers (en bleu) ont été correctement identifiés grâce à la méthode basée sur la distance de Mahalanobis.
Et vous, comment comptez-vous utiliser cet outil ?